 Simon의 AI 시대에 살아남는 법
앞선 글에서 다룬 다중 AI 모델 폴백 구조가 제대로 작동하려면, 지금 각 모델의 한도가 얼마나 남았는지를 정확히 알아야 합니다. 이번 글은 무료 티어 한도 안에서 챗봇을 24시간 돌리기 위해 실제로 적용한 관리 방법들입니다.
사용량을 모델별로 따로 기록한다
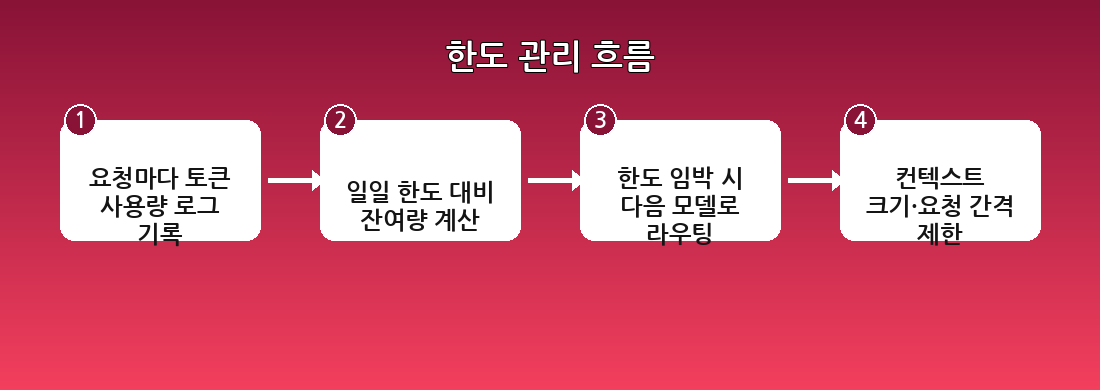
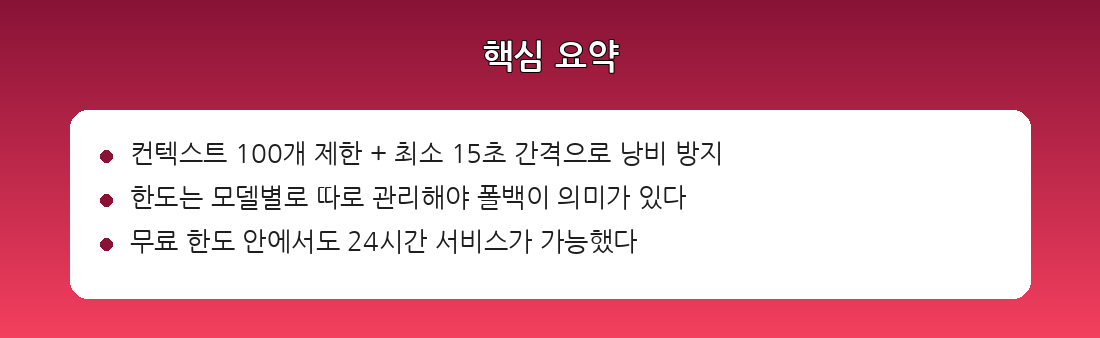
모든 AI 호출 결과를 로그 파일에 남기되, 모델별로 분리해서 관리합니다. Groq는 일일 토큰 총량을 별도 파일에 누적 기록하고, 다른 모델들도 각자의 한도 체계(요청 수 기준, 토큰 수 기준 등)에 맞춰 따로 추적합니다. 이렇게 모델별로 분리해두지 않으면 폴백 순서를 정할 때 “지금 어떤 모델이 여유가 있는지"를 판단할 근거가 없습니다.
요청 자체를 줄이는 두 가지 장치
한도 관리는 사용량을 기록하는 것만으로는 부족해서, 애초에 불필요한 요청을 줄이는 장치도 함께 넣었습니다.
- 대화 컨텍스트 길이 제한: 매 요청마다 이전 대화 전체를 계속 보내면 토큰 소모가 누적됩니다. 컨텍스트를 최근 100개 메시지로 제한해 한 번의 요청이 무한정 커지지 않도록 했습니다.
- 최소 요청 간격 설정: 같은 대화방에서 짧은 시간에 메시지가 몰릴 때 매번 API를 호출하는 대신, 최소 15초 간격을 두어 불필요한 중복 호출을 줄였습니다.
이 두 가지만으로도 무료 티어 소진 속도가 눈에 띄게 느려졌습니다.
한도가 다 찼을 때의 동작
한도가 임박하면 폴백 체인의 다음 모델로 자동 전환되고, 모든 모델이 한도를 소진한 극단적인 경우에는 사용자에게 “지금은 답변이 어렵다"는 메시지를 보내도록 만들어 최소한 조용히 무시되는 상황은 피했습니다. 실제로 예약된 자동화 루틴(예: 정기 시황 브리핑)이 한 주간 한도 소진으로 며칠간 실행되지 않은 적도 있었는데, 이런 사례를 겪으며 한도 관리의 중요성을 다시 체감했습니다.
🤖 이 포스팅은 AI의 도움을 받아 작성되었습니다.
💬 댓글