 Simon의 AI 시대에 살아남는 법
미국 증시 마감 시황 루틴을 운영하다 보면 자연스럽게 “이 데이터를 더 정확하고 안정적으로 가져올 방법이 없을까"라는 질문을 하게 됩니다. 유료 금융 데이터 API는 대부분 비용이 상당하지만, 웹페이지 형태로는 무료로 볼 수 있는 곳도 많습니다. 문제는 그런 사이트일수록 크롤링을 막아둔 경우가 많다는 점입니다. 실제로 몇몇 후보 사이트를 대상으로 간단히 점검해본 결과를 정리합니다.
점검 방법
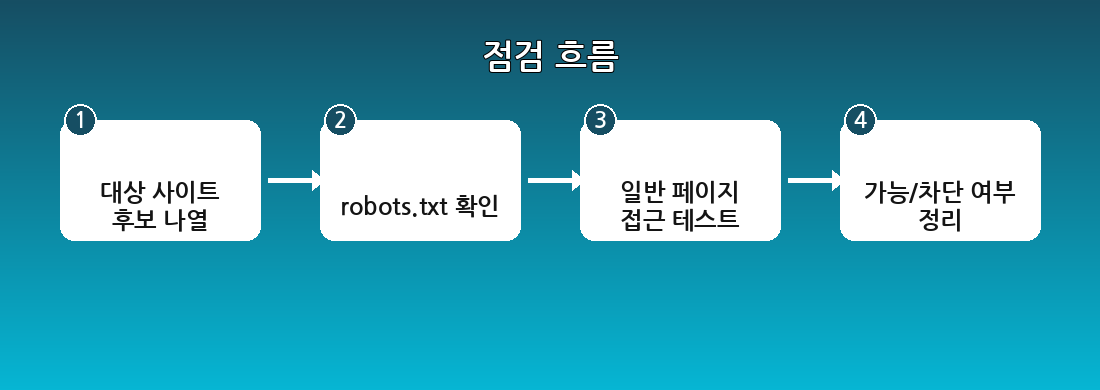
사이트마다 robots.txt를 먼저 확인하고, 이어서 일반적인 페이지 요청(curl)이 실제로 콘텐츠를 돌려주는지 테스트했습니다. 별도의 브라우저 자동화나 로그인 없이, 가장 단순한 방식으로 접근 가능한지만 확인하는 수준의 점검입니다.
결과: 사이트마다 접근성이 크게 갈렸다
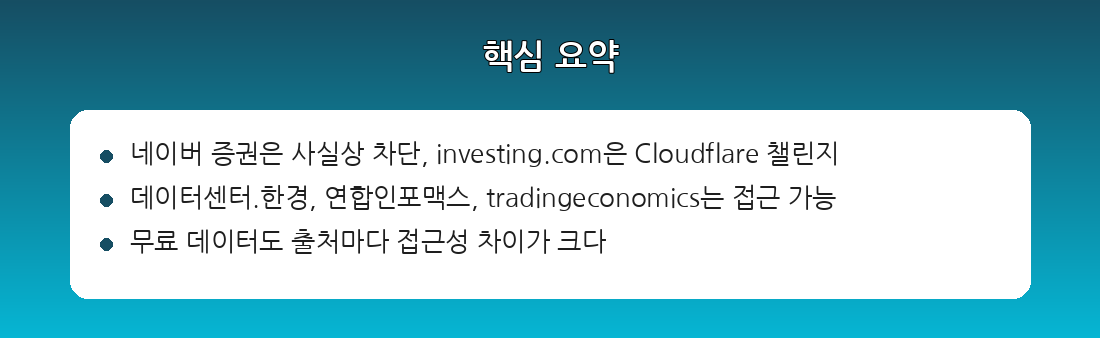
- 네이버 증권:
robots.txt에서 사실상 크롤링을 차단하고 있어, 데이터는 풍부하지만 직접 가져오기는 어려운 쪽이었습니다. - investing.com:
robots.txt요청 자체가 Cloudflare의 JS 챌린지 페이지로 돌아왔습니다. 즉 단순curl수준에서는 사실상 접근이 막혀 있다고 봐야 합니다. - datacenter.hankyung.com(한경 데이터센터): 별도 차단 없이 정상적으로 페이지 콘텐츠를 받아올 수 있었습니다.
- news.einfomax.co.kr(연합인포맥스): 마찬가지로 접근 가능했습니다.
- tradingeconomics.com: 접근 가능했으며, 다양한 거시경제 지표를 다루고 있어 참고하기 좋았습니다.
왜 이런 차이가 생기나
크롤링 차단 여부는 결국 그 사이트의 비즈니스 모델과 관련이 깊습니다. 데이터 자체가 핵심 자산인 서비스(대형 증권 포털, 유료 금융 데이터 업체)일수록 보호 장치가 강하고, 반대로 콘텐츠 유통이나 언론 성격이 강한 사이트는 상대적으로 접근이 열려 있는 경향이 있었습니다. 물론 이번 점검은 표면적인 수준이라, 실제 데이터 활용 전에는 각 사이트의 이용 약관도 함께 확인하는 게 맞습니다.
지금 파이프라인에는 어떻게 반영했나
현재 미국 증시 마감 시황 루틴은 특정 한 사이트에 의존하지 않고, 여러 출처를 검색해 교차검증하는 방식을 기본으로 하고 있습니다(자세한 내용은 이 시리즈의 앞선 글 “매일 미국 증시 마감 시황을 자동으로 조사·검증·발행하는 파이프라인"에서 다뤘습니다). 접근 가능한 사이트들은 교차검증용 출처 후보로 참고하되, 특정 사이트 하나에 파이프라인 전체가 의존하지 않도록 설계해둔 상태입니다.
🤖 이 포스팅은 AI의 도움을 받아 작성되었습니다.
💬 댓글